
메타데이터 필터링은 문서에 붙인 필드 값으로 검색할 자료의 범위를 좁히는 방법입니다. 날짜와 언어, 지역, 문서 종류, 상태, 권한 등을 조건으로 삼습니다.
사내 AI에 한국 지사의 휴가 규정을 물었는데 해외 지사의 규정이나 폐기된 문서가 검색되면 잘못된 답변으로 이어질 수 있습니다. 문서의 적용 지역과 사용 상태를 필터로 지정하면 이런 자료를 검색 후보에서 제외할 수 있습니다.
문서를 설명하는 필드와 검색 조건
휴가 신청 문서에는 본문 외에 언어와 적용 지역, 문서 종류, 사용 상태, 수정 연도 등을 저장할 수 있습니다.
{
  "language": "ko",
  "region": "KR",
  "document_type": "policy",
  "status": "active",
  "updated_year": 2026
}
위 필드로 region=KR, status=active, updated_year>=2026이라는 조건을 모두 만족하도록 요청하면 한국에 적용되는 현행 문서 중 2026년 이후 수정된 자료만 검색합니다. 이 표기는 조건을 설명한 예이며, 실제 요청은 사용하는 검색 제품의 필터 문법에 맞춰 작성해야 합니다.
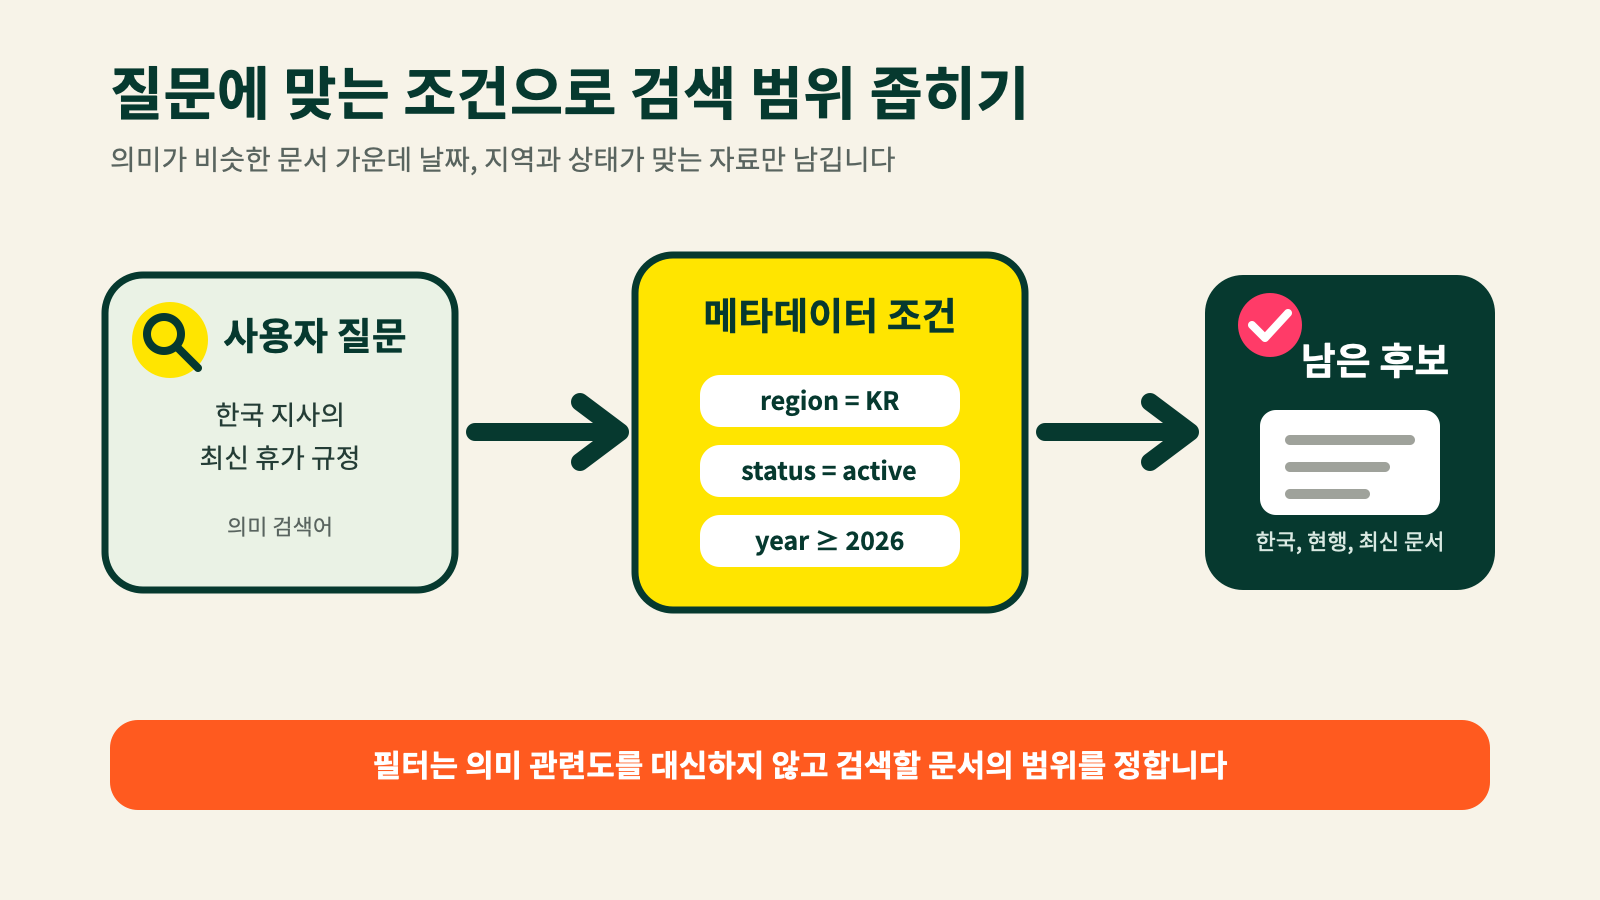
필터 조건을 충족한 문서라도 질문과 관련성이 낮으면 상위 결과에 나오지 않을 수 있습니다. 필터는 검색 대상을 제한하고, 관련도 평가는 결과의 순서를 정합니다.
사전 필터와 사후 필터
| 방식 | 적용 순서 | 확인할 한계 |
|---|---|---|
| 사전 필터 | 조건을 만족하는 문서를 대상으로 벡터 검색 결과를 찾습니다. | 조건을 만족하는 문서가 적으면 검색 과정에서 더 많은 후보를 탐색해 처리 시간이 늘 수 있습니다. |
| 사후 필터 | 먼저 찾은 후보에서 조건에 맞지 않는 문서를 제외합니다. | 조건에 맞는 문서가 검색 대상에 있어도 초기 후보에 들지 못하면 결과에서 누락될 수 있습니다. |
Azure AI Search의 preFilter는 벡터 검색 과정에서 조건을 검사합니다. postFilter는 샤드마다 찾은 후보를 필터링한 뒤 결과를 합칩니다. 샤드는 검색 인덱스를 나눈 저장 단위입니다. Amazon S3 Vectors도 벡터 후보를 탐색하면서 필터 조건을 검사합니다.
필드를 저장했다고 모두 필터에 쓸 수 있는 것은 아닙니다. Azure AI Search에서는 필드를 filterable로 설정해야 하며, S3 Vectors에서 필터 불가 필드로 지정한 메타데이터는 조건에 사용할 수 없습니다.
날짜와 상태, 권한 필터의 용도
- 날짜: 2026년 이후 수정한 자료처럼 기간을 제한합니다.
- 언어와 지역: 한국어 문서 중 한국에 적용되는 정책을 찾습니다.
- 문서 종류: 블로그를 제외하고 공식 매뉴얼만 검색합니다.
- 상태: 초안과 폐기 문서를 빼고 현재 사용하는 문서만 남깁니다.
- 권한: 사용자가 열람할 수 있는 부서나 프로젝트의 자료로 한정합니다.
권한 조건은 사용자의 질문 문장에만 맡기지 않고 로그인한 사용자의 실제 권한에서 정해야 합니다. 검색 API와 원본 저장소에서도 접근을 통제해, 필터가 누락된 요청으로 비공개 자료를 가져오지 못하게 설계합니다.
수정 연도는 내용의 유효 기간과 다를 수 있습니다. 오래전에 작성했지만 여전히 유효한 규정은 날짜 필터에서 빠질 수 있고, 본문을 고치지 않고 수정일 필드만 갱신한 문서는 최신 자료로 잘못 분류될 수 있습니다. 현행 규정을 찾는 목적이라면 날짜뿐 아니라 실제 사용 상태를 관리해야 합니다.
시맨틱 검색과 리랭커의 역할
하이브리드 검색처럼 키워드와 벡터 검색을 함께 쓰는 경우에도 필터를 적용할 수 있습니다. 제품에 따라 필터가 적용되는 검색 단계와 범위가 다르므로 두 검색 결과에 같은 조건이 적용되는지 확인해야 합니다.
자체 RAG와 공개 AI 검색의 차이
자체 RAG에서는 어떤 필드를 저장하고 어떤 조건으로 검색할지 운영자가 정합니다. 스키마 마크업으로 공개 웹페이지에 발행일이나 문서 유형을 적는 일과는 다릅니다. 공개 AI 검색이 그 값을 수집해 같은 필터 조건으로 적용하는지는 해당 서비스의 구현에 달려 있습니다.
필터 적용 후 검증
- 예상 답변의 근거 문서를 정하고 그 문서의 필드 값과 자료형을 확인합니다. 연도를 문자열로 저장했다면 숫자 비교 연산자를 적용할 수 있는지 확인해야 합니다.
- 질문에서 만든 조건이 실제 요구와 맞는지 봅니다. 현행 규정을 묻는 질문에 불필요한 수정 연도 제한을 붙이지 않았는지 확인합니다.
- 필터 적용 전후의 결과를 비교해 근거 문서가 어느 조건에서 제외되는지 찾습니다.
- 서로 다른 권한의 계정으로 같은 질문을 보내 비공개 문서가 결과에 섞이지 않는지 시험합니다.
결과가 0개일 때는 누락된 필드와 잘못된 조건부터 고칩니다. 권한 필터까지 자동으로 해제해 결과를 채워서는 안 됩니다.
자주 묻는 질문
메타데이터 필터링은 벡터 검색에만 쓰나요?
아닙니다. 키워드 검색에서도 날짜나 문서 유형 같은 필드로 범위를 제한할 수 있습니다. 벡터 검색에서는 의미 유사도만으로 구별하기 어려운 적용 지역과 사용 상태 등을 제한할 때 유용합니다.
필터를 먼저 적용하는 방식이 항상 더 좋은가요?
사전 필터는 조건에 맞는 문서를 초기 후보에서 놓치는 문제를 줄일 수 있지만, 조건이 까다로우면 검색 시간이 늘 수 있습니다. 사후 필터는 먼저 찾은 후보를 줄이므로 요청한 수보다 적은 결과만 남을 수 있습니다. 근거 문서가 결과에 포함되는지와 응답 시간을 기준으로 비교합니다.
메타데이터 필터링으로 최신 정보만 찾을 수 있나요?
정확한 수정일이 있다면 최근에 수정한 문서로 범위를 좁힐 수 있습니다. 다만 파일 수정일만으로 내용이 현재 유효한지는 알 수 없습니다. 데이터 신선도를 관리하려면 개정 여부와 시행일, 폐기 상태도 실제 문서와 맞춰야 합니다.
구조화 데이터를 넣으면 AI가 필터에 쓰나요?
자동으로 연결되는 것은 아닙니다. 자체 RAG라면 수집한 구조화 데이터를 저장소의 필드에 넣고 검색 조건으로 전달하도록 구현해야 합니다. 공개 AI 검색의 내부 처리는 사이트 운영자가 같은 방식으로 지정할 수 없습니다.
함께 알아두면 좋은 용어
- 벡터 데이터베이스: 임베딩 벡터와 메타데이터를 저장하고 검색하는 시스템
- 시맨틱 검색: 단어의 일치뿐 아니라 의미와 문맥을 고려하는 검색
- 리랭커: 1차 검색 후보의 관련도를 다시 평가해 순서를 조정하는 구성 요소
- RAG: 찾은 외부 자료를 생성 모델에 제공해 답을 만드는 구조