
크롤링은 검색로봇이 웹페이지를 찾아 접속하고 페이지 내용과 필요한 파일을 가져오는 과정입니다. 검색로봇은 내부 링크와 외부 링크, 사이트맵에서 새 URL을 찾고, 이전에 방문한 페이지에도 다시 접속해 바뀐 내용을 확인합니다.
새 글을 발행해도 검색로봇이 주소를 발견하고 수집하기까지 시간이 걸립니다. 수집한 뒤에는 내용을 분석해 색인에 저장할지 판단하고, 검색어에 맞는 결과를 골라 보여 줍니다. 따라서 발행, 크롤링, 검색 노출은 같은 시점에 일어나지 않습니다.
검색로봇이 페이지를 찾고 가져오는 방법
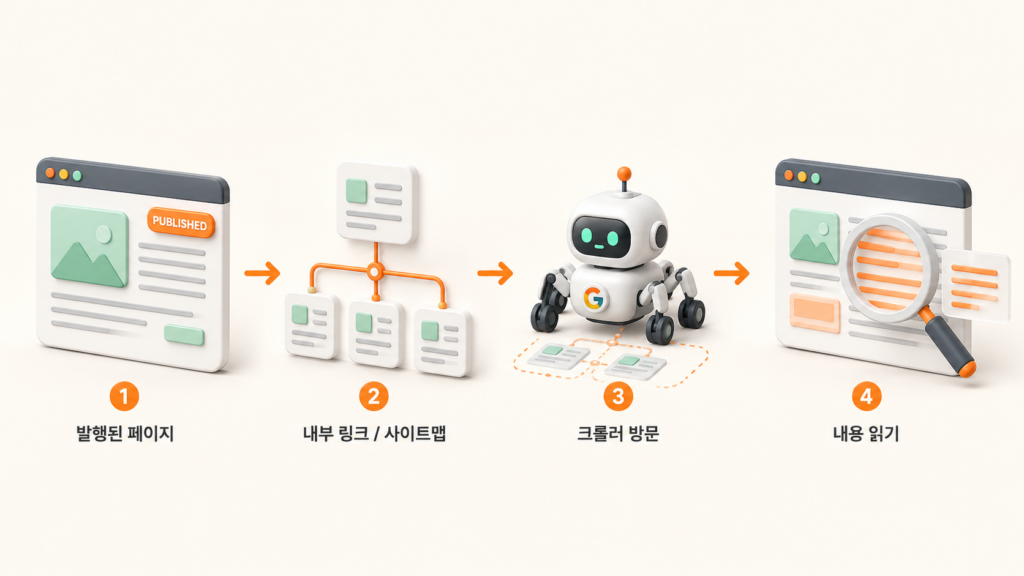
크롤러는 웹페이지를 찾아다니는 자동화 프로그램입니다. 이미 방문한 페이지의 링크를 따라가거나 사이트맵에 적힌 URL을 읽어 새 주소를 찾습니다. 주소에 접속한 뒤에는 서버에 HTML과 필요한 파일을 요청합니다. 검색엔진에 따라 JavaScript를 실행해 화면에 나타나는 내용을 확인하기도 합니다.
새 글로 연결되는 링크가 없다면 검색로봇이 사이트 안의 링크를 따라 그 글에 도달할 수 없습니다. URL을 알릴 때는 내부 링크와 사이트맵을 활용합니다.
사이트맵을 제출해도 목록의 모든 URL을 즉시 방문하는 것은 아닙니다. 언제 크롤링하고 색인할지는 검색엔진이 판단합니다.
서비스별 검색 크롤러
구글은 Googlebot, 네이버는 Yeti라는 검색로봇으로 웹페이지를 수집합니다. 같은 페이지라도 각 검색엔진의 크롤러가 접근할 수 있는지 따로 확인해야 합니다.
OpenAI는 검색용 OAI-SearchBot과 학습용 GPTBot을 구분해 운영합니다. 사용자가 요청한 페이지를 가져오는 ChatGPT-User도 별도로 안내합니다. 학습에 쓸 수집만 막으려면 검색용 봇까지 차단하지 않도록 대상을 구별해야 합니다.
Google의 AI 기능 안내는 AI Overviews와 AI Mode도 Google 검색 색인을 바탕으로 참조 링크를 제시한다고 설명합니다. OAI-SearchBot을 허용했다는 사실만으로 Google의 크롤링이나 색인 상태를 알 수는 없습니다.
크롤링, 색인, 노출의 단계 구분
검색로봇이 방문한 기록과 검색에 나온 기록은 따로 확인해야 합니다. 각 단계에서 검색엔진이 하는 일이 다르기 때문입니다.
- 크롤링: 크롤러가 페이지와 자원을 발견하고 가져오는 과정
- 색인: 검색엔진이 페이지 정보를 분석하고 검색 색인에 저장하는 과정
- 노출: 색인된 페이지가 검색결과에 표시되는 것
구글이 페이지를 읽었더라도 반드시 색인하는 것은 아닙니다. 검색에 보여줄 필요가 없다고 판단하면 색인에서 제외할 수 있습니다. 색인된 뒤에도 검색어와 얼마나 관련 있는지, 콘텐츠 품질이 어떤지에 따라 실제 노출과 순위가 달라집니다.
robots.txt는 접근을, noindex는 색인을 제어합니다
robots.txt와 noindex는 모두 검색로봇을 제어하지만 역할이 다릅니다.
- robots.txt에서는 크롤러가 접근할 수 있는 경로를 정합니다.
- noindex는 해당 페이지를 검색 색인에서 제외하라는 지시입니다.
Google의 noindex 안내는 noindex가 작동하려면 크롤러가 페이지에 접근할 수 있어야 한다고 명시합니다. robots.txt로 접근을 막으면 Googlebot이 페이지 안의 noindex를 읽을 수 없습니다. 따라서 검색결과에서 제외하려는 페이지에 두 설정을 함께 적용하면 의도와 달리 URL이 검색결과에 남을 수 있습니다.
robots.txt는 페이지를 숨기거나 보호하는 장치가 아닙니다. 검색결과 제외에는 목적에 맞게 noindex나 페이지 삭제를 사용하고, 공개하면 안 되는 정보는 로그인이나 접근 권한으로 보호해야 합니다.
페이지를 가져오지 못하거나 본문을 놓치는 원인
검색로봇이 주소를 알아도 접근이 막히거나 본문을 읽지 못할 수 있습니다. 다음 항목을 확인하세요.
- 로그인해야 볼 수 있는 콘텐츠: 외부 크롤러는 로그인한 사용자에게만 보이는 내용을 읽을 수 없습니다. 검색되길 원하는 핵심 정보는 공개 페이지에도 정리해 두세요.
- JavaScript 실행 오류: 코드 실행 후에 본문이 나타나는 페이지는 검색로봇이 필요한 파일을 가져와 실행할 수 있어야 합니다. Google URL 검사에서 렌더링된 HTML에 핵심 내용이 있는지 확인합니다.
- 이미지 안에만 들어 있는 글자: 핵심 설명과 수치, 제품 정보, 질문과 답변은 이미지 밖의 본문에도 적어 주세요. 이미지 설명 문구인 alt는 긴 본문을 대신할 수 없습니다.
- 검색로봇을 막는 보안 설정: robots.txt에서 허용했더라도 방화벽이 Googlebot이나 Yeti, AI 검색용 봇을 차단하면 페이지를 읽을 수 없습니다. 네이버도 robots.txt와 방화벽을 함께 확인하라고 안내합니다.
크롤링 실패 원인을 찾는 순서
Google Search Console이나 네이버 서치어드바이저에 사이트를 등록하고 URL 검사에서 해당 페이지의 수집 상태를 확인합니다. 마지막으로 언제 가져왔는지, 가져오기에 실패했다면 어떤 오류가 표시되는지 기록합니다.
- URL을 발견하지 못했다면 사이트맵에 포함돼 있고 다른 페이지의 내부 링크로 연결되는지 확인합니다.
- 주소는 발견했는데 수집하지 못했다면 robots.txt 규칙과 방화벽의 차단 기록을 살펴봅니다.
- 서버가 오류로 응답했는지, 예상하지 못한 주소로 이동시켰는지 확인합니다.
- 페이지는 가져왔는데 본문이 빠졌다면 필요한 JavaScript와 API의 실행 결과를 대조합니다.
확인 결과는 세 가지로 나눌 수 있습니다.
💡크롤링 관련 이슈
– 발견: 크롤러가 주소를 찾지 못한 경우
– 접근: 주소는 알지만 페이지에 들어오지 못한 경우
– 해석: 페이지에 들어왔지만 내용을 제대로 읽지 못한 경우
수정 후에는 같은 URL로 다시 검사해 실패 원인이 사라졌는지 확인합니다. 사이트 전체에서 반복된다면 개별 글보다 공통 템플릿과 서버 설정을 조사해야 합니다.
자주 묻는 질문
크롤링됐는데 왜 검색에 안 나오나요?
크롤링과 색인은 다른 단계입니다. 검색로봇이 페이지를 가져갔어도 색인하지 않을 수 있습니다. 개별 페이지는 Search Console URL 검사에서 마지막 크롤링과 현재 색인 상태를 확인하고, 사이트 전체 경향은 페이지 색인 생성 보고서에서 봅니다.
사이트맵만 제출하면 크롤링이 빨라지나요?
사이트맵은 검색로봇에 URL을 알리는 데 도움이 되지만 방문 속도나 순서를 보장하지는 않습니다. 사이트 안에서 연결된 링크가 없는 고아 페이지라면 관련 페이지에도 내부 링크를 추가하세요.
robots.txt로 페이지를 막으면 검색에서 바로 사라지나요?
그렇지 않습니다. robots.txt는 크롤러의 접근만 막을 뿐이라, 다른 페이지가 그 URL을 링크하고 있으면 본문 없이 주소만 검색결과에 남을 수 있습니다. 검색 제외가 목적이라면 크롤링을 허용한 상태에서 noindex를 사용해야 합니다.
함께 알아두면 좋은 용어
- 색인: 검색엔진이 페이지 정보를 저장해 검색결과 후보로 만드는 과정
- 사이트맵: 검색엔진에 중요한 URL을 알려 주는 파일
- robots.txt: 크롤러가 접근할 수 있는 범위를 알려 주는 파일
- noindex: 특정 페이지를 검색 색인에서 제외하라는 지시
- 내부 링크: 사이트 안의 페이지끼리 연결하는 링크
- URL 검사: 구글 서치 콘솔에서 개별 URL의 크롤링과 색인 상태를 확인하는 기능
- JavaScript SEO: JavaScript로 만든 페이지를 검색엔진이 읽고 이해할 수 있게 설계하는 작업
- 네이버 서치어드바이저: 네이버 검색로봇 수집 상태와 사이트 설정을 확인하는 도구
- AI 검색 크롤러: AI 검색 결과에 쓸 웹페이지를 찾는 자동화 프로그램
- AI 학습 크롤러: 모델 학습 자료를 수집하는 자동화 프로그램
- llms.txt: AI 도구에 사이트의 주요 문서와 링크를 안내하려는 파일 형식 제안. Google Search의 필수 파일은 아님